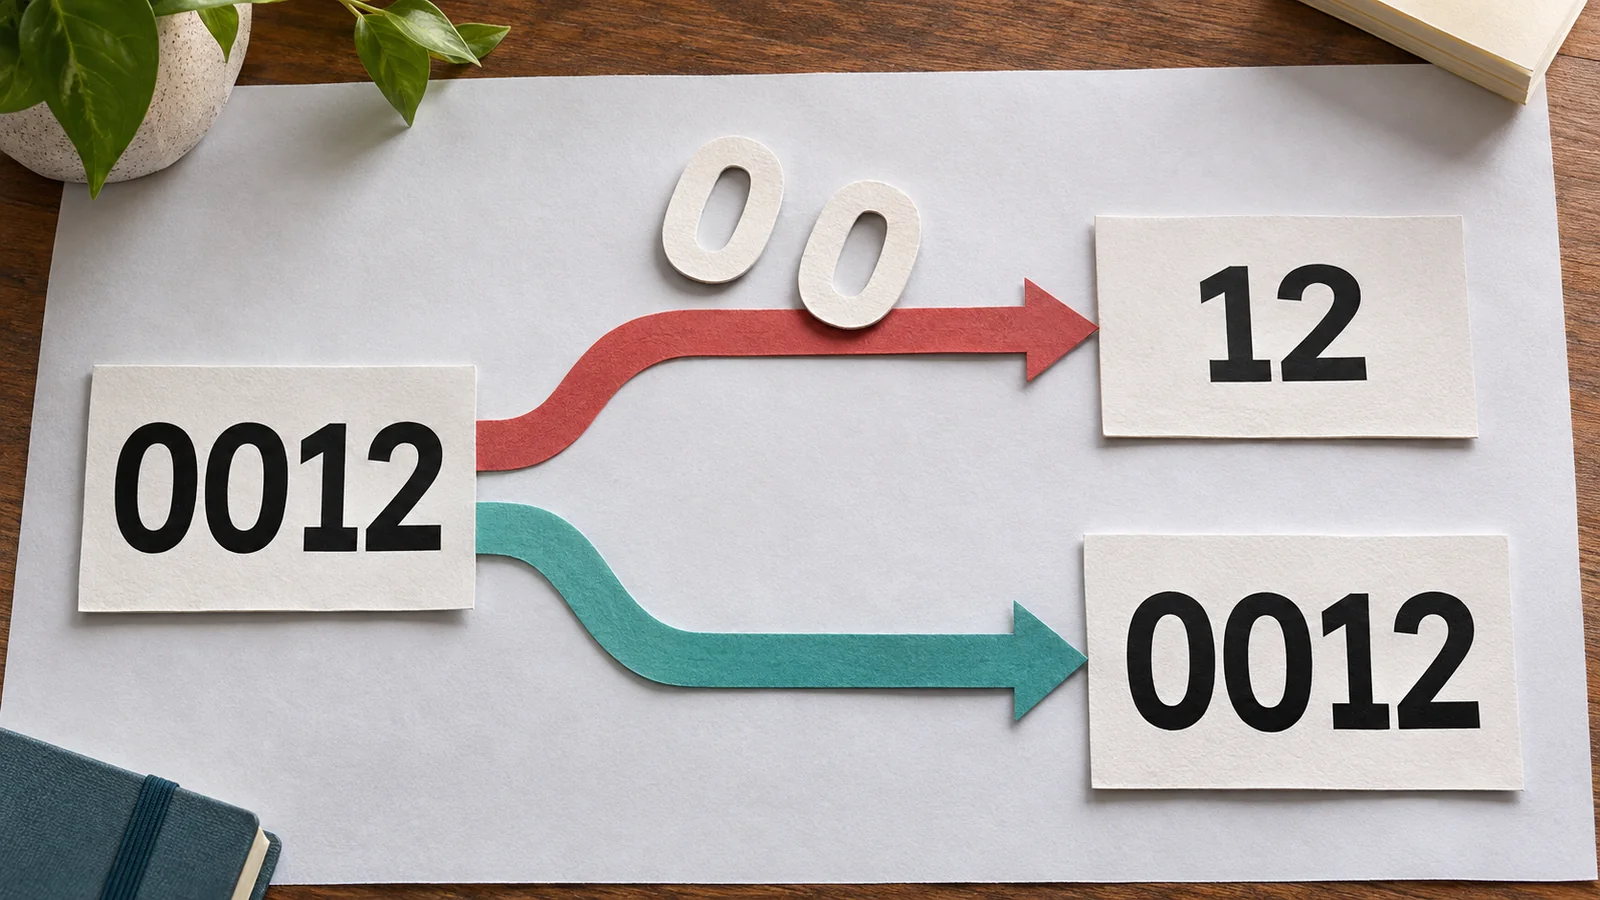
파이썬 pandas CSV에서 앞자리 0이 사라졌다면 식별자 열이 숫자로 해석됐는지 먼저 확인합니다. 고객번호·우편번호·상품코드처럼 계산 대상이 아닌 값은 read_csv()에서 해당 열을 문자열로 지정하고 결측값 정책도 함께 맞춰 원본 표기를 보존합니다. 이미 0012가 12로 읽혔다면 단순히 astype(str)로 바꿔도 잃어버린 0을 알 수 없으므로, 원본 CSV를 다시 읽을 수 있는지부터 확인해야 합니다.
먼저 식별자 열만 문자열로 읽습니다
전체 데이터를 무조건 문자열로 바꾸기보다, 식별자처럼 표기 자체가 의미인 열을 지정하는 편이 후속 계산과 검증을 구분하기 쉽습니다. dtype에 열별 타입을 넘기면 해당 열만 문자열 dtype으로 읽을 수 있습니다.
import pandas as pd

df = pd.read_csv(
    "orders.csv",
    dtype={
        "customer_id": "string",
        "postal_code": "string",
        "product_code": "string",
    },
)

print(df[["customer_id", "postal_code", "product_code"]].head())
여기서 중요한 것은 숫자처럼 보인다는 이유만으로 식별자를 숫자 열로 취급하지 않는 것입니다. 합계나 범위 계산이 필요한 측정값은 숫자 열로 남기고, 매칭 키와 코드처럼 원문 표기를 비교하는 값은 문자열로 분리하는 것이 안전합니다.
dtype와 converters는 목적이 다릅니다
식별자를 문자열로 읽으려면 dtype={열: "string"}을 먼저 고려합니다. 반면 읽는 순간 공백 제거, 접두어 처리처럼 열별 함수를 적용해야 한다면 converters를 고려할 수 있습니다. pandas 문서에 따르면 converters가 지정되면 dtype 변환 대신 converter가 적용되고, 함수는 파일에서 읽은 원문 텍스트에 적용됩니다.
df = pd.read_csv(
    "orders.csv",
    converters={
        "customer_id": lambda value: value.strip(),
    },
)
다만 converter 안에서 숫자형으로 바꾸면 앞자리 0 보존 목적과 충돌할 수 있습니다. 운영 코드에서는 먼저 “원문을 문자열로 보존할 것인가”와 “읽는 순간 정규화할 것인가”를 결정하고, 후자라면 그 변환 규칙을 코드와 검증 항목에 함께 남기는 편이 좋습니다.
NA 같은 코드가 결측값으로 바뀌는 경우
문자열 dtype을 지정해도 결측값 해석은 별도로 확인해야 합니다. read_csv()의 기본 결측값 목록에는 NA, N/A, NULL, NaN 등이 포함되어 있으므로, 실제 업무에서 NA가 유효한 상품코드라면 의도와 다르게 결측값이 될 수 있습니다.
기본 결측값 목록을 사용하지 않고 원문 문자열을 우선 보존하려면 다음처럼 읽습니다.
df = pd.read_csv(
    "orders.csv",
    dtype={"product_code": "string"},
    keep_default_na=False,
)
keep_default_na=False이고 na_values를 지정하지 않으면 문자열을 결측값으로 해석하지 않습니다. 빈 문자열이나 별도의 코드가 실제 결측을 뜻하는지에 따라 na_values를 함께 정해야 합니다. 즉, NA가 유효한 코드인지 결측 표기인지 원본 시스템의 약속을 먼저 확인해야 합니다.
이미 앞자리 0을 잃었다면
다음 코드는 타입만 문자열로 바꿀 뿐입니다.
df["customer_id"] = df["customer_id"].astype("string")
12가 원래 0012였는지, 정말 12였는지는 현재 값만으로 판단할 수 없습니다. 코드 길이 규칙을 공식적으로 알고 있다면 별도의 패딩 규칙을 적용할 수 있지만, 그 규칙이 확인되지 않은 상태에서 임의로 0을 채우면 다른 식별자를 변형할 수 있습니다. 원본 CSV나 upstream 추출 결과가 남아 있다면 그 파일을 다시 읽으면서 dtype와 결측값 정책을 지정하는 것이 우선입니다.
저장한 뒤에는 다시 읽어 확인합니다
DataFrame을 CSV로 저장한 뒤에는 메모리 안의 DataFrame만 확인하지 말고, 실제로 기록된 파일을 다시 읽어 식별자 값을 비교합니다. 아래 예제의 df는 앞에서 식별자 열을 문자열로 읽은 DataFrame이며, 각 코드 예제는 독립적으로 선택해 사용합니다.
output_path = "orders_clean.csv"
df.to_csv(output_path, index=False)

reloaded = pd.read_csv(
    output_path,
    dtype={"customer_id": "string", "postal_code": "string"},
    keep_default_na=False,
)

assert reloaded["customer_id"].equals(df["customer_id"])
assert reloaded["postal_code"].equals(df["postal_code"])
검증할 때는 식별자 열의 값뿐 아니라 결측값 정책도 같은 조건으로 맞춰야 합니다. 원본 DataFrame에 실제 결측값이 있다면 저장 시 표현과 재로드 시 na_values를 함께 정해야 하며, 그렇지 않으면 빈 문자열과 결측값의 차이로 비교가 실패할 수 있습니다. 다른 프로그램에서 CSV를 열어 보이는 모양과 pandas가 다시 읽은 값이 다를 수 있으므로, 자동화 파이프라인의 기준은 재로드 결과와 명시적인 비교로 두는 편이 분명합니다.
선택 기준을 짧게 정리하면
- 식별자 원문을 보존하려면
read_csv()의dtype에서 해당 열을string으로 지정합니다. - 읽는 순간 원문에 함수를 적용해야 할 때만
converters를 선택하고, 함수가 숫자로 바꾸지 않는지 확인합니다. NA같은 문자열 코드가 유효하다면keep_default_na와na_values를 원본 결측값 약속에 맞춰 정합니다.- 이미 0이 사라졌다면
astype(str)만으로 복구되지 않으므로 원본 재수집 또는 확인된 규칙에 따른 복원을 판단합니다. to_csv()뒤에는 같은 문자열·결측값 조건으로 파일을 다시 읽어 핵심 식별자를 비교합니다.