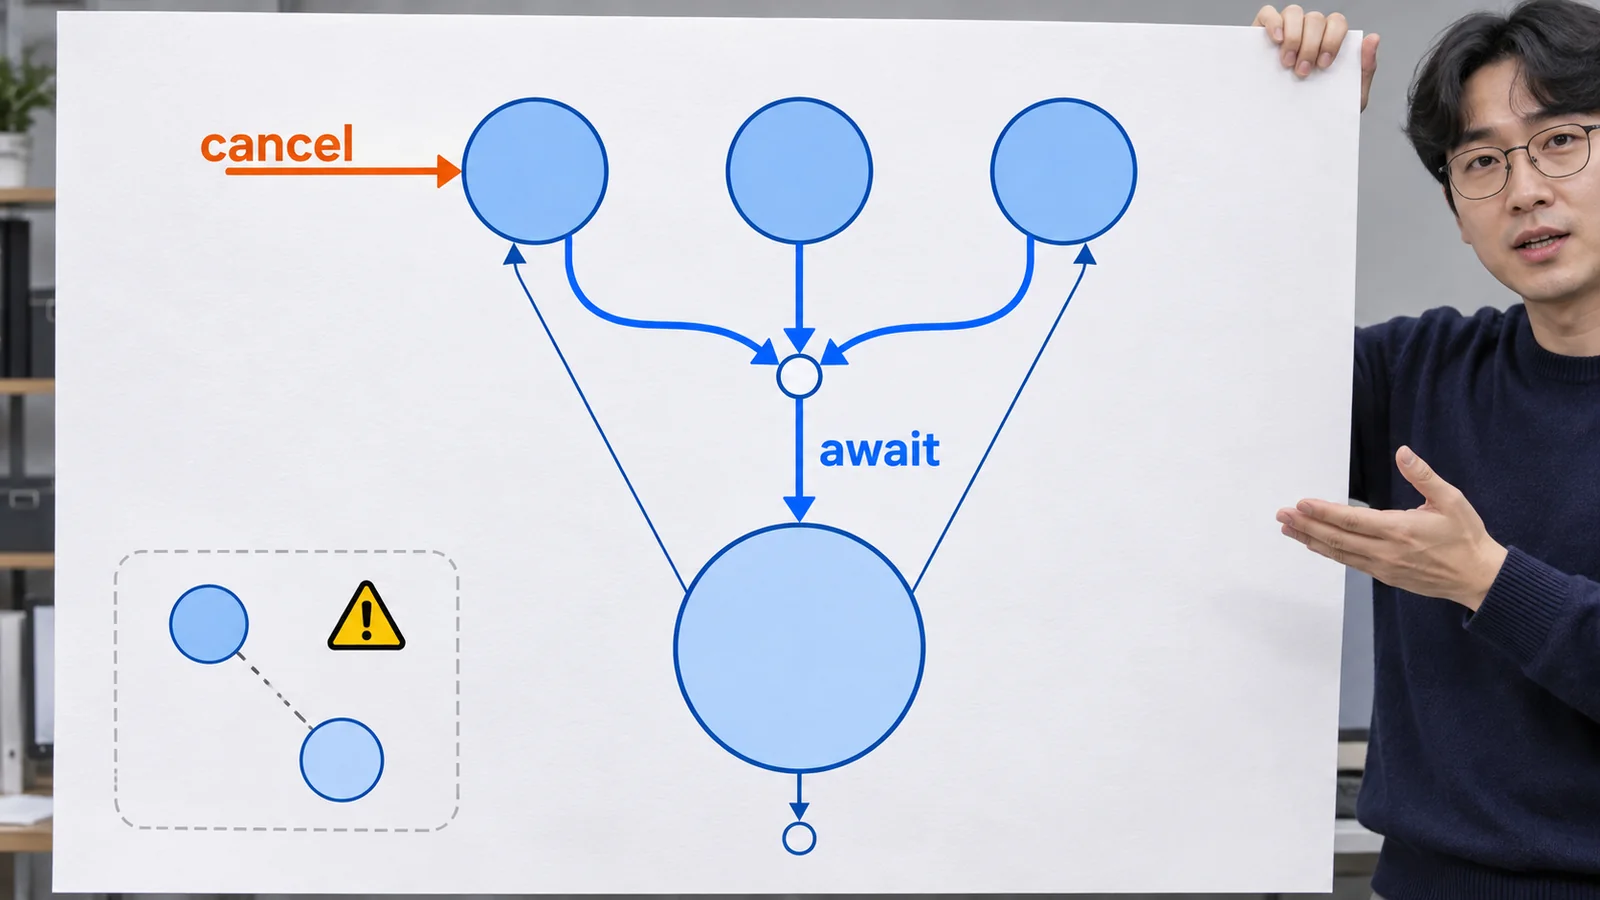
파이썬 asyncio 작업을 안전하게 취소하려면 task.cancel()만 호출해서는 부족합니다. 취소 요청 뒤에 task가 종료할 때까지 기다려야 pending task와 비정상 종료를 줄일 수 있습니다. 운영 관점에서는 try/finally로 자원을 정리하고, CancelledError를 필요한 곳에서 다시 전파한 뒤, 여러 task를 await 또는 gather(return_exceptions=True)로 drain하는 순서를 먼저 잡는 것이 핵심입니다.
본문의 모든 코드 예제는 Python 3.11 이상을 기준으로 합니다. 비동기 API 호출, 크롤링, 배치 자동화를 중단할 때 로그에 “취소했다”는 기록만 남기고 프로그램을 끝내면 실제 작업 상태와 기록이 어긋날 수 있습니다. 처음에는 예외 문제처럼 보여도, task의 취소 요청과 취소 완료를 같은 것으로 착각한 lifecycle 문제일 수도 있습니다.
task.cancel()은 즉시 작업을 끝내지 않습니다
cancel()은 실행 중인 코루틴에 취소 요청을 보냅니다. 다음 실행 기회에 CancelledError가 주입되며, 이미 진입한 try 블록의 finally는 정리할 기회를 얻습니다. 기록된 CPython 3.13.14 재현에서는 task를 만든 직후 취소하고 기다렸을 때 코루틴 본문 진입과 finally 실행 표시가 모두 없었습니다. 따라서 코루틴이 시작하기 전에 확보한 자원은 그 자원을 소유한 쪽에서 별도로 정리해야 합니다. 따라서 다음 코드는 “취소 요청을 보낸다”는 의미에 가깝습니다.
for task in tasks:
    task.cancel()
이 호출 직후 task.done()이 참이라고 가정하거나, 곧바로 이벤트 루프를 닫는 것은 안전하지 않습니다. 네트워크 응답을 기다리던 코드가 finally 블록에서 연결·파일·락과 관련된 정리를 할 수도 있기 때문입니다. 취소를 종료로 확정하려면 호출한 쪽이 각 task를 다시 기다려야 합니다.
취소되는 코루틴은 try/finally에서 정리합니다
취소는 보통 정상적인 return 경로가 아닙니다. 그래서 코루틴이 실행 중에 확보한 자원의 정리 코드를 진입한 finally에 두는 방식이 유용합니다. 시작 전에 확보한 자원은 코루틴 본문의 정리에만 의존하지 말고 소유한 쪽에서 정리하도록 설계합니다. 아래 예제의 asyncio.sleep(1)은 실제 API 대신 취소 타이밍을 보여 주기 위한 예시이며, 1초는 측정값이 아닌 임의의 값입니다.
import asyncio


async def worker(name: str) -> None:
    try:
        while True:
            print(f"{name}: 작업 중")
            await asyncio.sleep(1)
    except asyncio.CancelledError:
        print(f"{name}: 취소 요청 확인")
        raise
    finally:
        print(f"{name}: 정리 작업")
except asyncio.CancelledError에서는 로그를 남기거나 자체 자원을 정리할 수 있습니다. 다만 정리가 끝난 뒤 raise하지 않고 예외를 삼키면 호출자는 task가 정상적으로 끝난 것처럼 판단할 수 있습니다. 특히 구조화된 동시성 기능은 취소가 전달되는 것을 전제로 동작하므로, 취소를 처리했다는 이유로 무조건 정상 완료로 바꾸지 않는 편이 좋습니다.
정리 코드 자체가 await를 필요로 한다면 그 작업도 취소 상황을 고려해야 합니다. 정리 과정에서 새 작업을 무한히 시작하거나, 취소된 상태를 무시한 채 오래 기다리면 graceful shutdown이 다시 멈출 수 있습니다. 정리의 목적은 업무를 계속하는 것이 아니라 현재 보유한 자원을 일관된 상태로 돌려놓는 데 있습니다.
여러 task는 취소 후 반드시 drain합니다
여러 task를 직접 만들었다면 종료 순서는 다음처럼 나누어 보는 것이 좋습니다.
- 살아 있는 task에 취소를 요청합니다.
- 모든 task를 await하여 취소 처리가 끝날 기회를 줍니다.
- 취소·예외 결과를 확인한 뒤 이벤트 루프나 상위 실행기를 종료합니다.
import asyncio


async def shutdown(tasks) -> None:
    current = asyncio.current_task()
    pending = [task for task in tasks if task is not current and not task.done()]

    for task in pending:
        task.cancel()

    if pending:
        results = await asyncio.gather(*pending, return_exceptions=True)
        for task, result in zip(pending, results):
            if isinstance(result, BaseException) and not isinstance(
                result, asyncio.CancelledError
            ):
                print(f"종료 중 예외: {task.get_name()} -> {result!r}")
여기서 return_exceptions=True는 취소된 task의 CancelledError나 다른 예외를 결과 목록에 모으는 역할을 합니다. 하나의 task 결과 때문에 나머지 task의 종료 확인을 건너뛰지 않으려는 drain 단계에서 유용합니다. 다만 모든 예외를 없던 일로 만든다는 뜻은 아니므로, 실제 운영 코드에서는 결과를 기록하거나 종료 상태에 반영해야 합니다. 이 예제는 이미 끝난 task를 제외하므로 그 task의 결과나 예외는 별도로 확인해야 합니다. 취소를 억제하고 끝나지 않는 task가 있다면 이 대기도 끝나지 않을 수 있습니다.
반대로 gather()의 기본 동작만 믿고 첫 예외를 받은 뒤 함수를 빠져나오면 다른 task가 계속 실행될 수 있습니다. 실패와 취소를 어떤 정책으로 처리할지 정한 다음, 남은 task를 취소하고 기다리는 코드를 별도로 두는 것이 판단하기 쉽습니다.
gather와 TaskGroup을 어떻게 구분할까요
gather()는 여러 awaitable의 결과를 한 번에 모으는 도구입니다. 기본 설정에서는 먼저 발생한 예외가 호출자에게 전달되지만, 다른 awaitable이 자동으로 모두 취소되는 것은 아닙니다. 따라서 이미 존재하는 task 묶음을 수집하거나, 결과 목록을 순서대로 받아야 하는 경우에 잘 맞습니다.
TaskGroup은 task를 한 묶음의 생명주기로 관리하고 싶을 때 고려할 구조입니다. 그룹 안의 task가 CancelledError 이외의 예외로 실패하면 남은 task를 취소하고 종료를 기다리므로, 부모 작업이 자식 task를 놓치지 않게 하는 데 유리합니다.
TaskGroup은 Python 3.11에 추가되었습니다.
다음 코드는 앞에서 정의한 worker를 사용하며, 외부에서 취소하지 않으면 반복 작업이 계속되는 예시입니다.
import asyncio


async def run_batch() -> None:
    async with asyncio.TaskGroup() as group:
        group.create_task(worker("one"), name="worker-one")
        group.create_task(worker("two"), name="worker-two")
두 도구 중 하나가 항상 정답인 것은 아닙니다. 이미 만들어 둔 task의 결과·예외를 수집하는 종료 루틴에는 gather(return_exceptions=True)가 읽기 쉽고, 한 작업 묶음의 실패를 나머지 작업과 함께 관리해야 한다면 TaskGroup이 생명주기를 더 분명하게 표현합니다. 중요한 것은 도구 이름보다 “누가 task를 만들었고, 누가 취소하며, 누가 마지막으로 기다리는가”를 코드에서 확인할 수 있게 만드는 것입니다.
Task was destroyed but it is pending!을 볼 때 확인할 것
이 경고는 감싸진 코루틴이 아직 끝나지 않았는데 task 객체가 소멸했다는 뜻입니다. task 참조를 관리하는 방식과 취소 후 완료 대기, 이벤트 루프 종료 순서를 확인해 원인을 좁혀야 합니다. 단순히 경고를 숨기기보다 종료 순서를 점검해야 합니다.
저라면 다음 순서로 좁혀 갑니다.
- task를 생성한 위치와 보관하는 컬렉션이 있는지 확인합니다.
- 종료 시점에 살아 있는 task를 모읍니다.
- 현재 task처럼 취소하면 안 되는 대상을 제외하고 취소합니다.
gather(return_exceptions=True)또는 해당 task의 await로 종료를 기다립니다.CancelledError가 중간 계층에서 삼켜지지 않는지 확인합니다.- 이벤트 루프를 닫는 코드가 모든 정리보다 먼저 실행되지 않는지 봅니다.
디버그 모드에서 생성 위치의 traceback을 함께 확인하면 어떤 경로에서 task가 남았는지 찾는 데 도움이 됩니다. 다만 경고가 사라졌다는 사실만으로 작업이 올바르게 끝났다고 결론 내리면 안 됩니다. 취소된 작업이 남긴 임시 상태, 파일, 연결을 정리했는지도 별도로 확인해야 합니다.
asyncio.run() 중첩도 종료 구조의 문제일 수 있습니다
애플리케이션의 진입점에서는 asyncio.run(main())처럼 하나의 실행 경계를 두고, 그 안에서 필요한 코루틴과 task를 관리하는 구성이 이해하기 쉽습니다. 같은 스레드에서 이미 실행 중인 이벤트 루프 안에서는 asyncio.run()을 다시 호출할 수 없으므로, 라이브러리 함수는 실행기를 새로 만들기보다 호출자에게 코루틴을 반환하는 편이 안전합니다.
다음 코드는 앞에서 정의한 worker와 shutdown을 함께 사용하며, asyncio.sleep(3)의 3초는 종료를 시연하기 위한 임의의 예시값입니다.
import asyncio


async def main() -> None:
    tasks = {
        asyncio.create_task(worker("batch-a"), name="batch-a"),
        asyncio.create_task(worker("batch-b"), name="batch-b"),
    }
    try:
        await asyncio.sleep(3)
    finally:
        await shutdown(tasks)


if __name__ == "__main__":
    asyncio.run(main())
이 구조에서 main()은 task를 만든 주체이자 종료를 책임지는 주체입니다. 실제 서비스에서는 운영체제 신호, 작업 큐의 종료 신호, 상위 프레임워크의 lifecycle에 맞춰 shutdown()을 호출하되, “취소 요청 → 정리 → await로 drain”이라는 순서는 유지하는 것이 좋습니다.
적용 전 마지막 판단
현재 문제가 단순히 CancelledError라는 예외 메시지인지, 아니면 취소·정리 lifecycle을 놓친 것인지부터 구분해 보십시오. task.cancel() 호출만 있고 그 뒤의 await가 없다면 pending task 가능성을 먼저 의심합니다. CancelledError를 잡은 뒤 raise하지 않는다면 취소 상태가 정상 완료처럼 바뀌는지 확인합니다. 여러 task를 한꺼번에 종료한다면 gather(return_exceptions=True)로 결과를 모을지, 애초에 TaskGroup으로 생명주기를 묶을지 선택합니다.
정리하면 안전한 종료의 핵심은 취소를 명령으로 끝내지 않고 상태 변화가 완료될 때까지 확인하는 데 있습니다. task를 만든 코드가 그 task의 마지막 await까지 책임지도록 구조를 잡으면, 비동기 자동화가 중단될 때 남은 작업과 종료 로그를 훨씬 정확하게 다룰 수 있습니다.
참고한 공식 문서
- Coroutines and Tasks — Python 3.14.7 documentation —
cancel(),CancelledError,TaskGroup의 취소 동작 - asyncio.gather — 예외 전달과
return_exceptions동작 - Python Task groups version availability —
TaskGroup도입 버전 - Pending task destroyed — pending task 경고의 의미
- Runners — Python 3.14.7 documentation —
asyncio.run()실행 경계