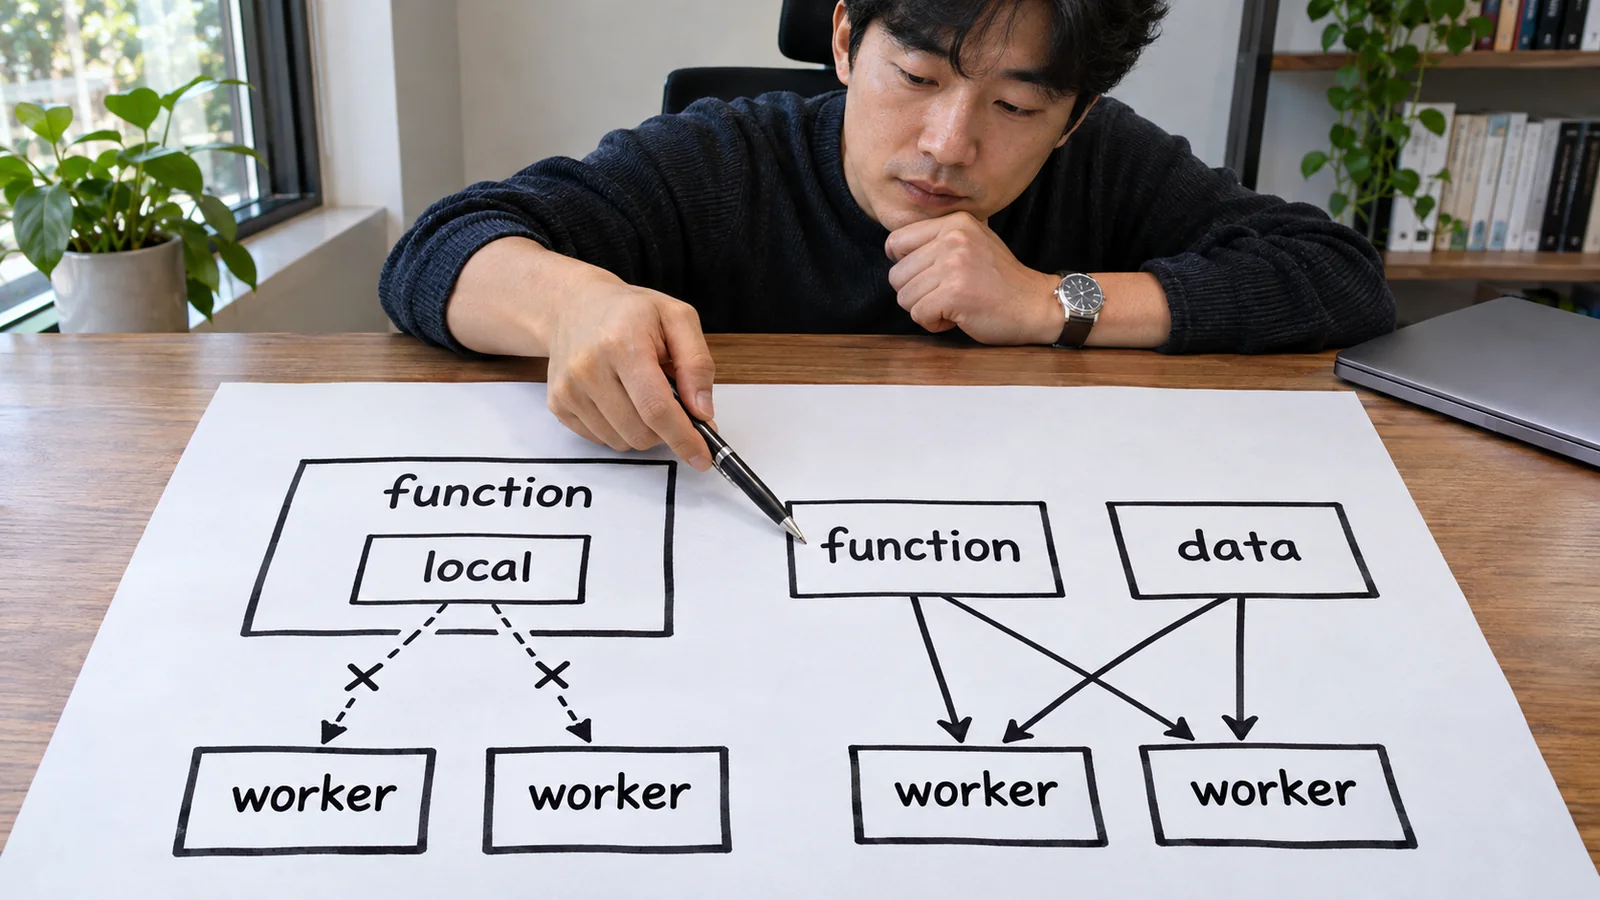
먼저 자식 프로세스에 넘기는 함수와 인자를 확인하고, 함수는 모듈 최상위의 이름 있는 함수로, 인자는 직렬화 가능한 데이터로 바꾸며, __main__ 진입점 문제는 별도로 구분해야 합니다. 파이썬 multiprocessing 또는 ProcessPoolExecutor에서 Can't pickle local object가 나오면 이 순서로 원인을 좁히는 것이 좋습니다. 함수가 중첩 함수·lambda이거나 인자에 실행 중인 객체가 들어 있으면 직렬화 단계에서 막힐 수 있습니다.
먼저 오류를 두 갈래로 나눕니다
프로세스 자동화에서 비슷해 보이는 오류를 한꺼번에 고치려 하면 수정 방향이 흔들립니다. 저는 다음 순서로 분류합니다.
Can't pickle local object,cannot pickle가 함수나 인자를 가리킨다: 전달할 객체의 picklability를 확인합니다.- 자식 프로세스가 모듈을 import하지 못하거나
__main__실행과 관련된RuntimeError가 난다: 진입점을 보호했는지 확인합니다.
freeze_support()는 동결된 실행 파일을 지원하기 위한 기능입니다. 일반적인 Python 실행에서 pickling 문제를 해결하는 만능 처방으로 볼 수는 없습니다.
함수는 모듈 최상위에 둡니다
pickle은 함수의 코드 전체를 복사하는 방식이 아니라 모듈과 정규화된 이름을 이용해 함수를 찾습니다. 따라서 작업 함수는 다른 함수 안이나 클래스 메서드의 지역 범위보다 모듈 최상위의 이름 있는 함수로 두는 편이 안전합니다. lambda와 REPL에서 정의한 함수는 ProcessPoolExecutor 작업에 정상적으로 동작한다고 기대하기 어렵습니다.
문제가 되는 구조는 다음과 같습니다.
from concurrent.futures import ProcessPoolExecutor

def run(numbers):
    def square(value):
        return value * value

    with ProcessPoolExecutor() as executor:
        return list(executor.map(square, numbers))
square를 모듈 최상위로 옮기고, 실행 진입점과 작업 데이터를 분리합니다.
from concurrent.futures import ProcessPoolExecutor

def square(value: int) -> int:
    return value * value

def main() -> None:
    numbers = [int(value) for value in input("정수를 공백으로 구분해 입력하세요: ").split()]
    with ProcessPoolExecutor() as executor:
        results = list(executor.map(square, numbers))
    print(results)

if __name__ == "__main__":
    main()
이 구조의 핵심은 if __name__ == "__main__": 자체가 모든 pickle 오류를 고친다는 뜻이 아닙니다. 작업 함수가 import 가능한 위치에 있고, 자식 프로세스가 모듈을 안전하게 import할 수 있도록 실행 코드를 진입점 아래에 둔다는 뜻입니다.
인자는 실행 객체가 아니라 데이터로 바꿉니다
submit()이나 map()에 전달하는 함수뿐 아니라 인자와 반환값도 프로세스 경계를 넘어갑니다. 문자열·바이트·숫자·단순 컨테이너처럼 내부 원소까지 직렬화 가능한 데이터로 작업 인터페이스를 설계하면 원인을 좁히기 쉽습니다.
반대로 열린 파일 핸들, 소켓, HTTP 세션처럼 이미 실행 중인 자원을 작업 인자로 직접 넘기는 설계는 피하는 편이 좋습니다. 이 객체들이 모든 환경에서 같은 방식으로 실패한다고 단정하기보다, 실제 전달 경로에서 pickle.dumps()로 개별 확인하고 작업자 안에서 만들 수 있는 자원인지 검토해야 합니다.
import pickle

def can_serialize(value: object) -> bool:
    try:
        pickle.dumps(value)
    except Exception:
        return False
    return True

def fetch_one(url: str) -> str:
    # 세션 같은 실행 자원은 이 함수의 데이터 인자로 넘기지 않습니다.
    return url
이 검사는 전달하려는 값을 먼저 확인하는 용도일 뿐이며, 예외를 폭넓게 잡으므로 실제 진단에서는 예외 내용도 기록하는 것이 좋습니다. 함수가 import 가능한지, 반환값도 프로세스 밖으로 돌아올 수 있는지, 실제 start method에서 같은 경로를 타는지는 별도로 확인해야 합니다.
작업자별 자원은 initializer를 검토합니다
각 작업자가 사용할 데이터베이스 연결이나 HTTP 클라이언트처럼 프로세스 안에서 만들어야 하는 자원이 있다면, 부모 프로세스의 객체를 그대로 전달하기보다 작업자 시작 시 초기화하는 구조를 검토합니다. ProcessPoolExecutor의 initializer는 각 작업자 프로세스가 시작될 때 호출되고 initargs를 전달할 수 있습니다.
다만 initializer가 파일·네트워크 자원의 수명과 오류 처리를 자동으로 해결해 주는 것은 아닙니다. 연결 실패, 정리 시점, 재시도 정책을 운영 코드에서 따로 정해야 하며, 단순한 데이터 처리라면 자원을 문자열이나 숫자 같은 설정값으로 표현한 뒤 작업자 함수가 필요한 시점에 열도록 하는 편이 명확합니다.
수정 전 체크 순서
다음 네 가지를 순서대로 확인하면 문제를 비교적 빠르게 분리할 수 있습니다.
- traceback이 함수 이름을
local또는lambda로 지목하는지 확인합니다. - 작업 함수를 모듈 최상위의 이름 있는 함수로 옮깁니다.
- 인자와 반환값에서 파일·소켓·세션 같은 실행 중 객체를 제거하고 데이터만 전달합니다.
- 별도의
RuntimeError가 있다면__main__진입점 보호와 import 가능한 모듈 구조를 확인합니다.
그래도 경계가 불분명하면 작은 값부터 pickle.dumps()로 확인하고, 프로세스 병렬화가 꼭 필요한지도 다시 판단합니다. 작업이 I/O 중심이고 공유 자원 때문에 설계가 복잡해진다면 ThreadPoolExecutor나 단일 프로세스가 더 맞을 수 있지만, 이 글의 pickle 오류만으로 선택을 단정할 수는 없습니다.
정리
Can't pickle local object의 첫 대응은 우회 패키지를 찾는 일이 아니라 프로세스 경계를 넘는 대상을 단순화하는 일입니다. 함수는 모듈 최상위의 이름 있는 함수로, 인자는 직렬화 가능한 데이터로 두고, 작업자별 자원은 initializer 또는 작업자 내부 초기화를 검토하면 됩니다. 그와 별개로 __main__ 진입점 문제를 분리해 확인해야 수정 결과를 정확히 판단할 수 있습니다.
더 살펴볼 질문
- ProcessPoolExecutor와 ThreadPoolExecutor 중 어떤 것을 선택할까?
- multiprocessing 작업이 Windows·macOS에서만 실패하는 이유는?
- 프로세스 작업 결과와 예외를 안전하게 수집하는 방법은?