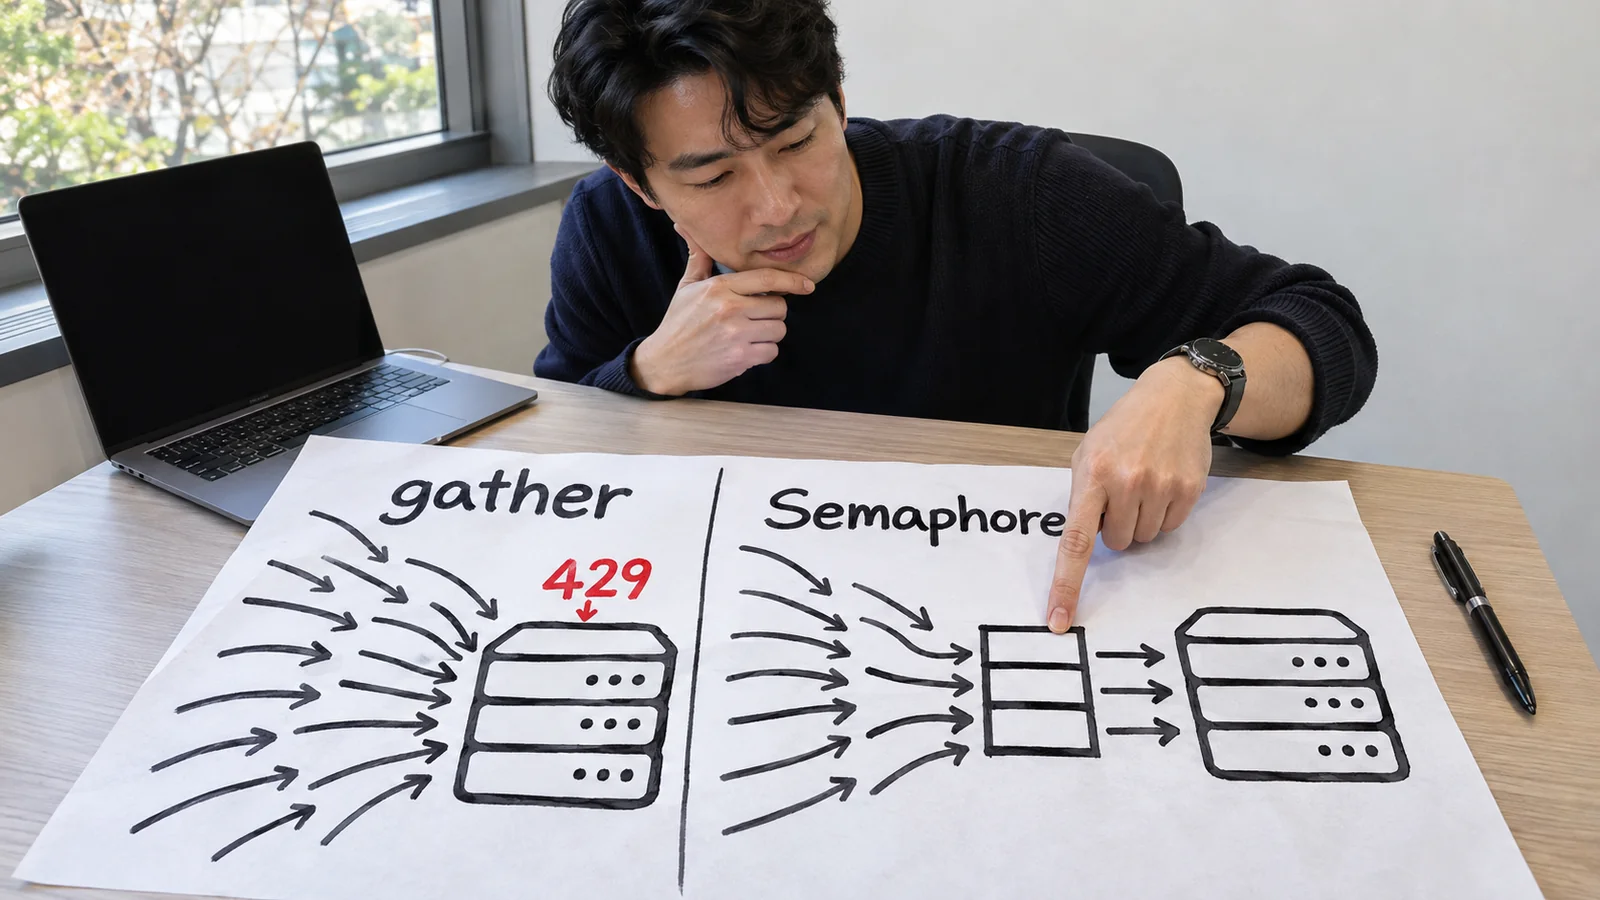
파이썬 asyncio 동시 요청 제한은 gather를 쓸지 Semaphore를 둘지보다, 한 번에 외부 작업에 진입해도 되는 상한을 먼저 정하는 문제입니다. gather는 여러 awaitable을 함께 실행하는 도구이고, Semaphore는 동시에 진입할 수 있는 작업 수를 제한하는 도구이므로 둘은 대체 관계가 아닙니다. 실패한 작업의 취소까지 한 묶음으로 다뤄야 한다면 TaskGroup의 동작도 함께 확인해야 합니다.
이 글에서는 외부 API나 웹 요청을 asyncio로 병렬 처리할 때 세 도구를 어떤 기준으로 나누어 쓰는지 설명합니다. 특정 서비스의 허용량이나 정답인 동시성 숫자를 제시하지 않고, 실제 환경에서 상한을 정하고 실패를 확인하는 순서에 집중하겠습니다.
먼저 구분할 것: 작업을 함께 기다리는 일과 진입을 제한하는 일
asyncio.gather(*aws)는 전달한 awaitable들을 함께 실행하고 결과를 모아 받는 형태입니다. 따라서 작업 목록이 작고, 대상 서비스와 로컬 자원이 감당할 범위를 이미 알고 있다면 gather만으로도 구조가 충분할 수 있습니다.
반대로 코루틴 목록이 크거나 각 작업이 같은 외부 서비스·연결 풀·파일 같은 자원을 사용한다면, 모두를 한꺼번에 실행 대상으로 만드는 것 자체가 부담이 될 수 있습니다. 이때 필요한 것은 gather를 포기하는 일이 아니라, 실제 요청을 보내는 구간에 Semaphore를 두는 일입니다.
import asyncio


async def request_data(item: str) -> str:
    # 외부 요청 대신 입력을 돌려주는 가상 응답입니다.
    return item


async def fetch_one(item: str, limit: asyncio.Semaphore) -> str:
    async with limit:
        # 이 블록 안에서 외부 요청과 응답 처리를 수행합니다.
        return await request_data(item)


async def fetch_all(items: list[str], concurrency: int) -> list[str]:
    limit = asyncio.Semaphore(concurrency)
    return await asyncio.gather(
        *(fetch_one(item, limit) for item in items)
    )
여기서 concurrency는 서비스 조건에 맞춰 정할 양의 정수입니다. 동시성 상한은 서비스의 문서와 계약, 클라이언트의 연결 한도, 요청의 무게, 로컬 메모리와 CPU, 실패 양상을 확인한 뒤 정해야 합니다. 근거 없이 숫자를 키우면 처리량이 늘어난다고 단정할 수 없습니다.
Semaphore는 요청 수가 아니라 동시 진입을 제한합니다
Semaphore는 acquire가 성공할 때 내부 카운터를 줄이고 release할 때 다시 늘립니다. 카운터가 0이면 다른 작업이 release될 때까지 acquire에서 기다립니다. 그러므로 이는 일정 시간 동안 보낼 수 있는 총 요청 수를 정하는 rate limit과는 다른 개념입니다.
상한의 범위도 중요합니다. 대기열에 코루틴을 등록하는 부분 전체를 감싸기보다, 실제로 제한하려는 외부 요청 또는 공유 자원 사용 구간을 async with limit: 안에 두는 편이 의도를 분명하게 합니다. 한 작업이 요청 전후의 긴 CPU 처리까지 세마포어 안에서 수행하면, 요청 자체보다 넓은 구간이 슬롯을 점유할 수 있습니다.
async with를 사용하는 이유는 예외나 취소가 발생해도 정리 경로를 확보하기 위해서입니다. 공식 문서에서 설명하듯 async with sem은 acquire 뒤 finally에서 release하는 방식과 동등한 형태로 동작합니다. 직접 acquire()와 release()를 나누어 쓰는 코드라면 예외가 나는 모든 경로에서 release가 빠지지 않는지 확인해야 합니다.
gather의 예외 전파를 오해하지 않기
gather의 return_exceptions 기본값은 False입니다. 이 경우 구성 작업 중 예외가 발생하면 그 예외가 gather를 기다린 쪽으로 전파됩니다. 이미 다른 작업이 실행 중일 수 있으므로, 호출자가 예외를 받았다는 사실만으로 모든 작업이 자동으로 멈췄다고 간주하면 안 됩니다.
개별 실패를 수집하려면 각 작업에서 예상한 예외를 잡아 입력 항목과 함께 실패 결과로 기록하는 방법을 검토할 수 있습니다. 재시도 가능한 실패와 즉시 중단해야 하는 실패는 애플리케이션 수준에서 분류해야 합니다. 예외를 받은 뒤 gather.cancel()을 호출해도 이미 완료된 gather라면 다른 작업을 취소하지 못할 수 있습니다.
TaskGroup을 선택할 상황
작업을 하나의 묶음으로 관리하면서 한 작업의 실패가 나머지 작업의 취소로 이어져야 한다면 TaskGroup이 더 직접적인 표현이 될 수 있습니다. Python 공식 문서에 따르면 TaskGroup 안에서 CancelledError가 아닌 예외로 첫 작업이 실패하면 남은 작업을 취소하고, 정리 작업을 기다린 뒤 예외들을 예외 그룹으로 묶어 발생시킵니다.
import asyncio


async def fetch_all_with_group(items: list[str], concurrency: int) -> list[str]:
    limit = asyncio.Semaphore(concurrency)
    results: list[str] = []

    async def run(item: str) -> None:
        async with limit:
            value = await request_data(item)
            results.append(value)

    async with asyncio.TaskGroup() as group:
        for item in items:
            group.create_task(run(item))

    return results
앞의 가상 request_data 함수를 함께 사용하는 예제입니다. 실제 HTTP 요청으로 바꿀 때는 사용하는 클라이언트의 응답과 자원 정리 방식을 따르세요. TaskGroup을 사용할 수 있는 Python 버전인지도 실행 환경에서 확인해야 합니다.
이 예제에서 Semaphore는 동시에 요청하는 수를 줄이고, TaskGroup은 작업 묶음의 실패·취소 수명을 관리합니다. 둘은 서로 다른 책임입니다. 결과를 입력 순서와 동일하게 보존해야 한다면 results.append() 대신 입력 항목과 결과를 연결할 별도 구조를 설계해야 합니다. 이 글의 핵심은 그 결과 구조가 아니라, 동시성 제한과 실패 전파를 섞지 않는 데 있습니다.
취소 가능한 코루틴은 try/finally에서 연결·파일·임시 자원 등을 정리해야 합니다. CancelledError를 직접 잡는 경우에도 정리한 뒤 취소가 계속 전달되도록 설계하는 것이 안전합니다. async with limit를 사용하면 세마포어 슬롯도 정리 경로에 포함됩니다.
운영에서 상한을 정하는 확인 순서
처음부터 큰 숫자를 정하고 실패율을 보는 방식은 원인을 구분하기 어렵습니다. 다음 순서로 범위를 좁히는 편이 실무적으로 낫습니다.
- 대상 조건 확인: 서비스 문서나 계약에서 요청 제한, 연결 제한, 재시도 조건을 확인합니다. 확인되지 않은 허용량을 추정해 코드에 고정하지 않습니다.
- 요청 단위 확인: 한 작업이 점유하는 연결·메모리·CPU와 요청 시간이 어느 정도인지 관찰합니다. 동시성은 요청 수 제한과 같은 말이 아닙니다.
- 실패 분류: 예외, 취소, 타임아웃, 서버가 돌려준 응답을 구분해 기록합니다. 같은 재시도 정책을 모든 실패에 적용하지 않습니다.
- 정리 확인: 실패 후에도 세마포어가 반환되고, 취소된 요청과 클라이언트 자원이 남지 않는지 확인합니다.
요청 제한 응답을 만났다고 해서 세마포어 숫자만 낮추면 해결된다고 단정할 수는 없습니다. 이는 동시 진입과 시간당·분당 요청량, 서버의 응답 정책이 서로 다른 문제일 수 있기 때문입니다. 재시도와 요청 제한 응답 처리는 별도의 정책으로 분리해 대상 서비스의 조건에 맞게 정해야 합니다.
결론: 도구가 아니라 책임을 나누어 선택하기
작은 작업 묶음을 함께 실행하고 결과를 기다리는 것이 목적이면 gather가 출발점입니다. 동시에 외부 요청에 들어가는 수를 제한해야 하면 요청 구간을 Semaphore의 async with로 감쌉니다. 한 작업의 실패가 묶음 전체의 취소와 정리로 이어져야 하면 TaskGroup을 검토합니다.
다음으로 확인할 질문은 “몇 개가 가장 빠른가”가 아니라 “실패했을 때 무엇을 다시 시도하고 무엇을 취소할 것인가”입니다. 이 기준이 정해진 뒤에야 상한과 재시도 값을 운영 환경에 맞게 조정할 수 있습니다.